Big tech propongono una regola unica per bloccare l’addestramento AI: cosa cambia per i siti italiani
OpenAI, Google, Microsoft e Anthropic hanno introdotto un singolo token nel file robots.txt per impedire l’uso dei contenuti nei modelli generativi. Scopri i tempi di implementazione e l’impatto per editori e aziende.
Cosa è successo
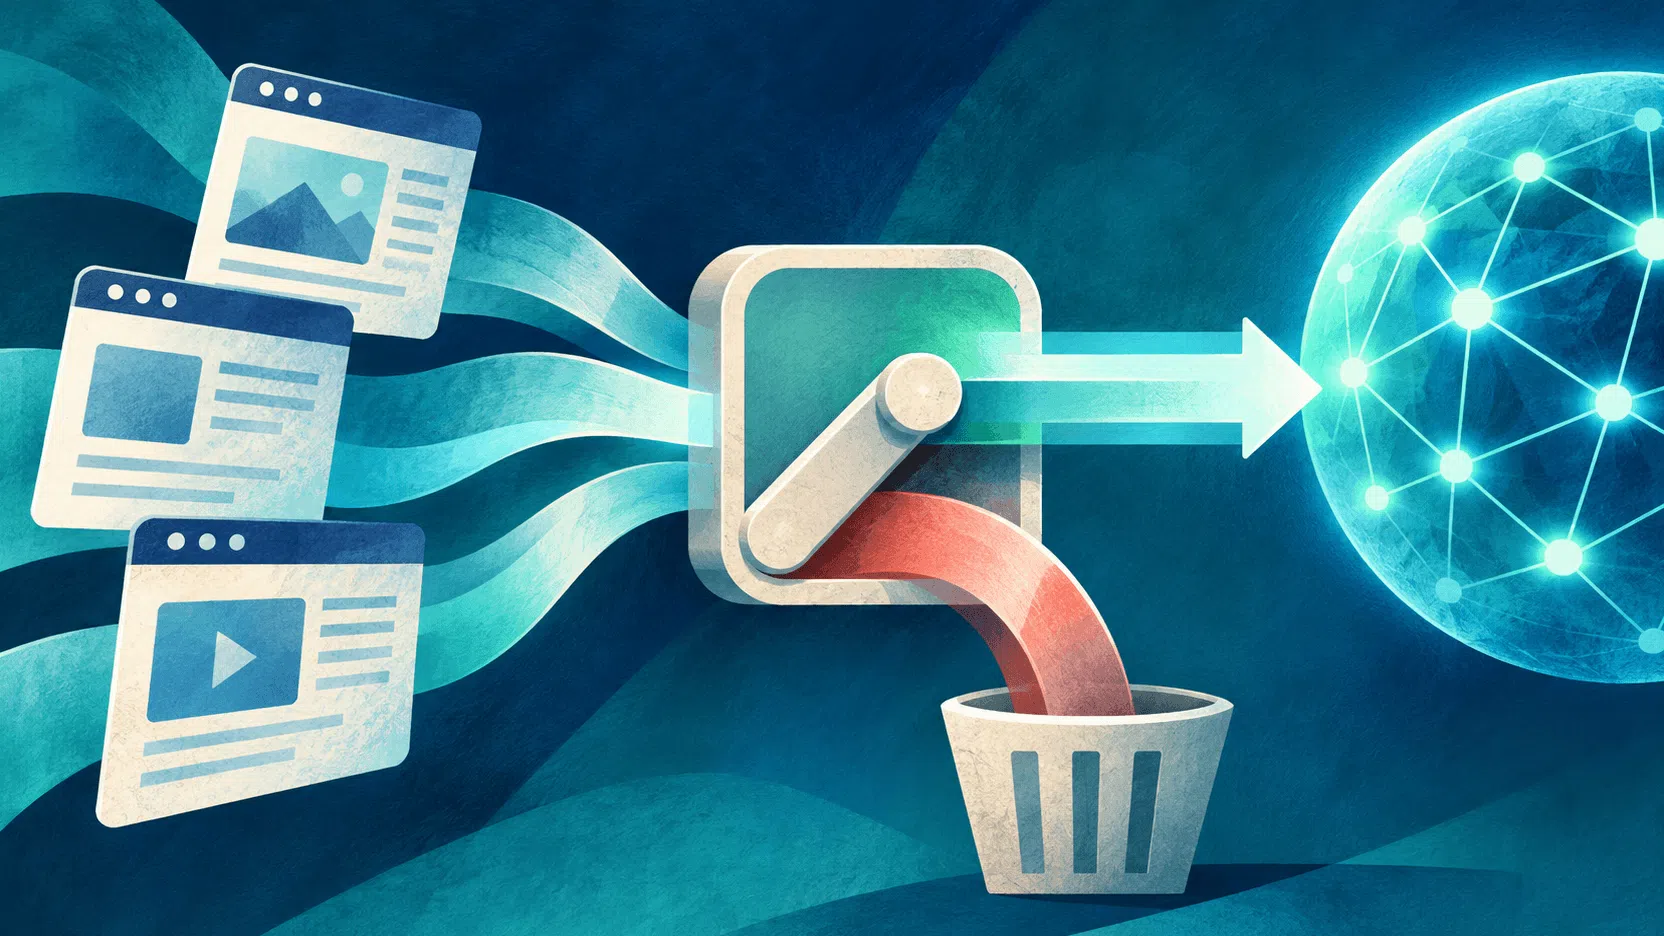
Il 30 ottobre 2026 OpenAI, Google, Microsoft e Anthropic hanno lanciato una proposta congiunta: un unico token, __usage_ai-training, da inserire nel file robots.txt dei propri siti web per escludere i contenuti dall’addestramento dei modelli generativi. La proposta, denominata Machine‑Readable Training Preference Signal, è stata presentata come Internet‑Draft all’IETF dal responsabile di Anthropic, Kevin Kelley.
Il nuovo segnale non blocca l’accesso dei crawler ai motori di ricerca, ma indica ai provider AI che i contenuti non devono essere usati per il training. In pratica, i motori possono ancora indicizzare le pagine, ma non possono impiegarle per addestrare i loro algoritmi.
Cosa cambia in pratica
- Privacy dei contenuti: i siti possono gestire in modo uniforme la loro esclusione dall’addestramento, evitando di dover configurare regole specifiche per ogni provider.
- Controlli aggiuntivi: Microsoft introdurrà un comando separato per le risposte AI, mentre Google collegherà la nuova preferenza a un controllo già usato per alcune funzioni di Gemini.
- Tempi di implementazione: OpenAI e Google prevedono di adottare il segnale nei prossimi mesi, Microsoft lo farà dal 1° febbraio 2027, Anthropic ha già avviato l’implementazione, ma la completa attivazione non è ancora fissata.
- Visibilità dei marchi: la differenza tra i controlli influisce sulla presenza dei brand nelle risposte generate dalle AI, con potenziali impatti sul traffico organico.
| Azienda | Impegno dichiarato | Tempistica |
|---|---|---|
| OpenAI | Riconoscerà il segnale comune | Nei prossimi mesi (data non fissata) |
| Riconoscerà il segnale insieme a Google‑Extended | 2027 | |
| Microsoft | Aggiungerà opzioni separate per le risposte AI | Dal 1° febbraio 2027 |
| Anthropic | Avvio dell’implementazione | Attivazione completa non indicata |
Cosa significa per chi compra in Italia
Per editori, e-commerce e aziende che pubblicano documentazione, la nuova regola offre un modo più semplice per proteggere i propri contenuti. Con un’unica riga nel robots.txt, è possibile escludere intere sezioni del sito dall’addestramento AI, mantenendo però l’indicizzazione per i motori di ricerca. Ciò riduce il rischio che dati sensibili o contenuti proprietari vengano usati per migliorare modelli di terzi, senza compromettere la visibilità online.
Inoltre, la distinzione tra training e grounding permette alle imprese di decidere se accettare che le AI consultino i propri siti per fornire risposte contestuali (grounding) pur escludendo i contenuti dal training. Questo può tradursi in un maggiore traffico verso il sito, grazie a link diretti nelle risposte AI, mentre i dati rimangono sotto controllo.
Per gli utenti finali, la regola non cambia l’esperienza di ricerca o l’uso quotidiano delle AI, ma garantisce una maggiore tutela della privacy dei contenuti pubblicati in Italia. Le aziende possono quindi gestire meglio la propria presenza digitale e la protezione dei propri asset digitali.
Domande frequenti
Come inserisco il nuovo token nel mio file robots.txt?
Inserisci le seguenti righe: User-Agent: __usage_ai-training seguito da Disallow: /. Se vuoi escludere solo parti del sito, aggiungi Allow per le cartelle che desideri rendere disponibili.
Il segnale impedirà ai motori di ricerca di indicizzare le mie pagine?
No. Il token è una preferenza di training, non un ordine di blocco. I crawler possono ancora indicizzare le pagine, ma non le usano per addestrare i modelli AI.
Quando sarà attivo il controllo per Microsoft?
Microsoft prevedeva di implementare il segnale e le opzioni separate per le risposte AI a partire dal 1° febbraio 2027.
Posso usare il segnale anche per proteggere contenuti sensibili?
Sì, è possibile escludere qualsiasi contenuto, inclusi dati sensibili o protetti da copyright, dall’addestramento AI, mantenendo l’indicizzazione per i motori di ricerca.
Per approfondire le implicazioni tecniche e legali di questa nuova regola, visita la sezione Informatica del nostro magazine.