
Dharma Field Extractor: l'AI che trasforma documenti in dati strutturati
Un modello da 2 miliardi di parametri estrae campi specifici da fatture e moduli, restituendo JSON pronto per i sistemi aziendali. Costi ridotti rispetto alle API generiche.
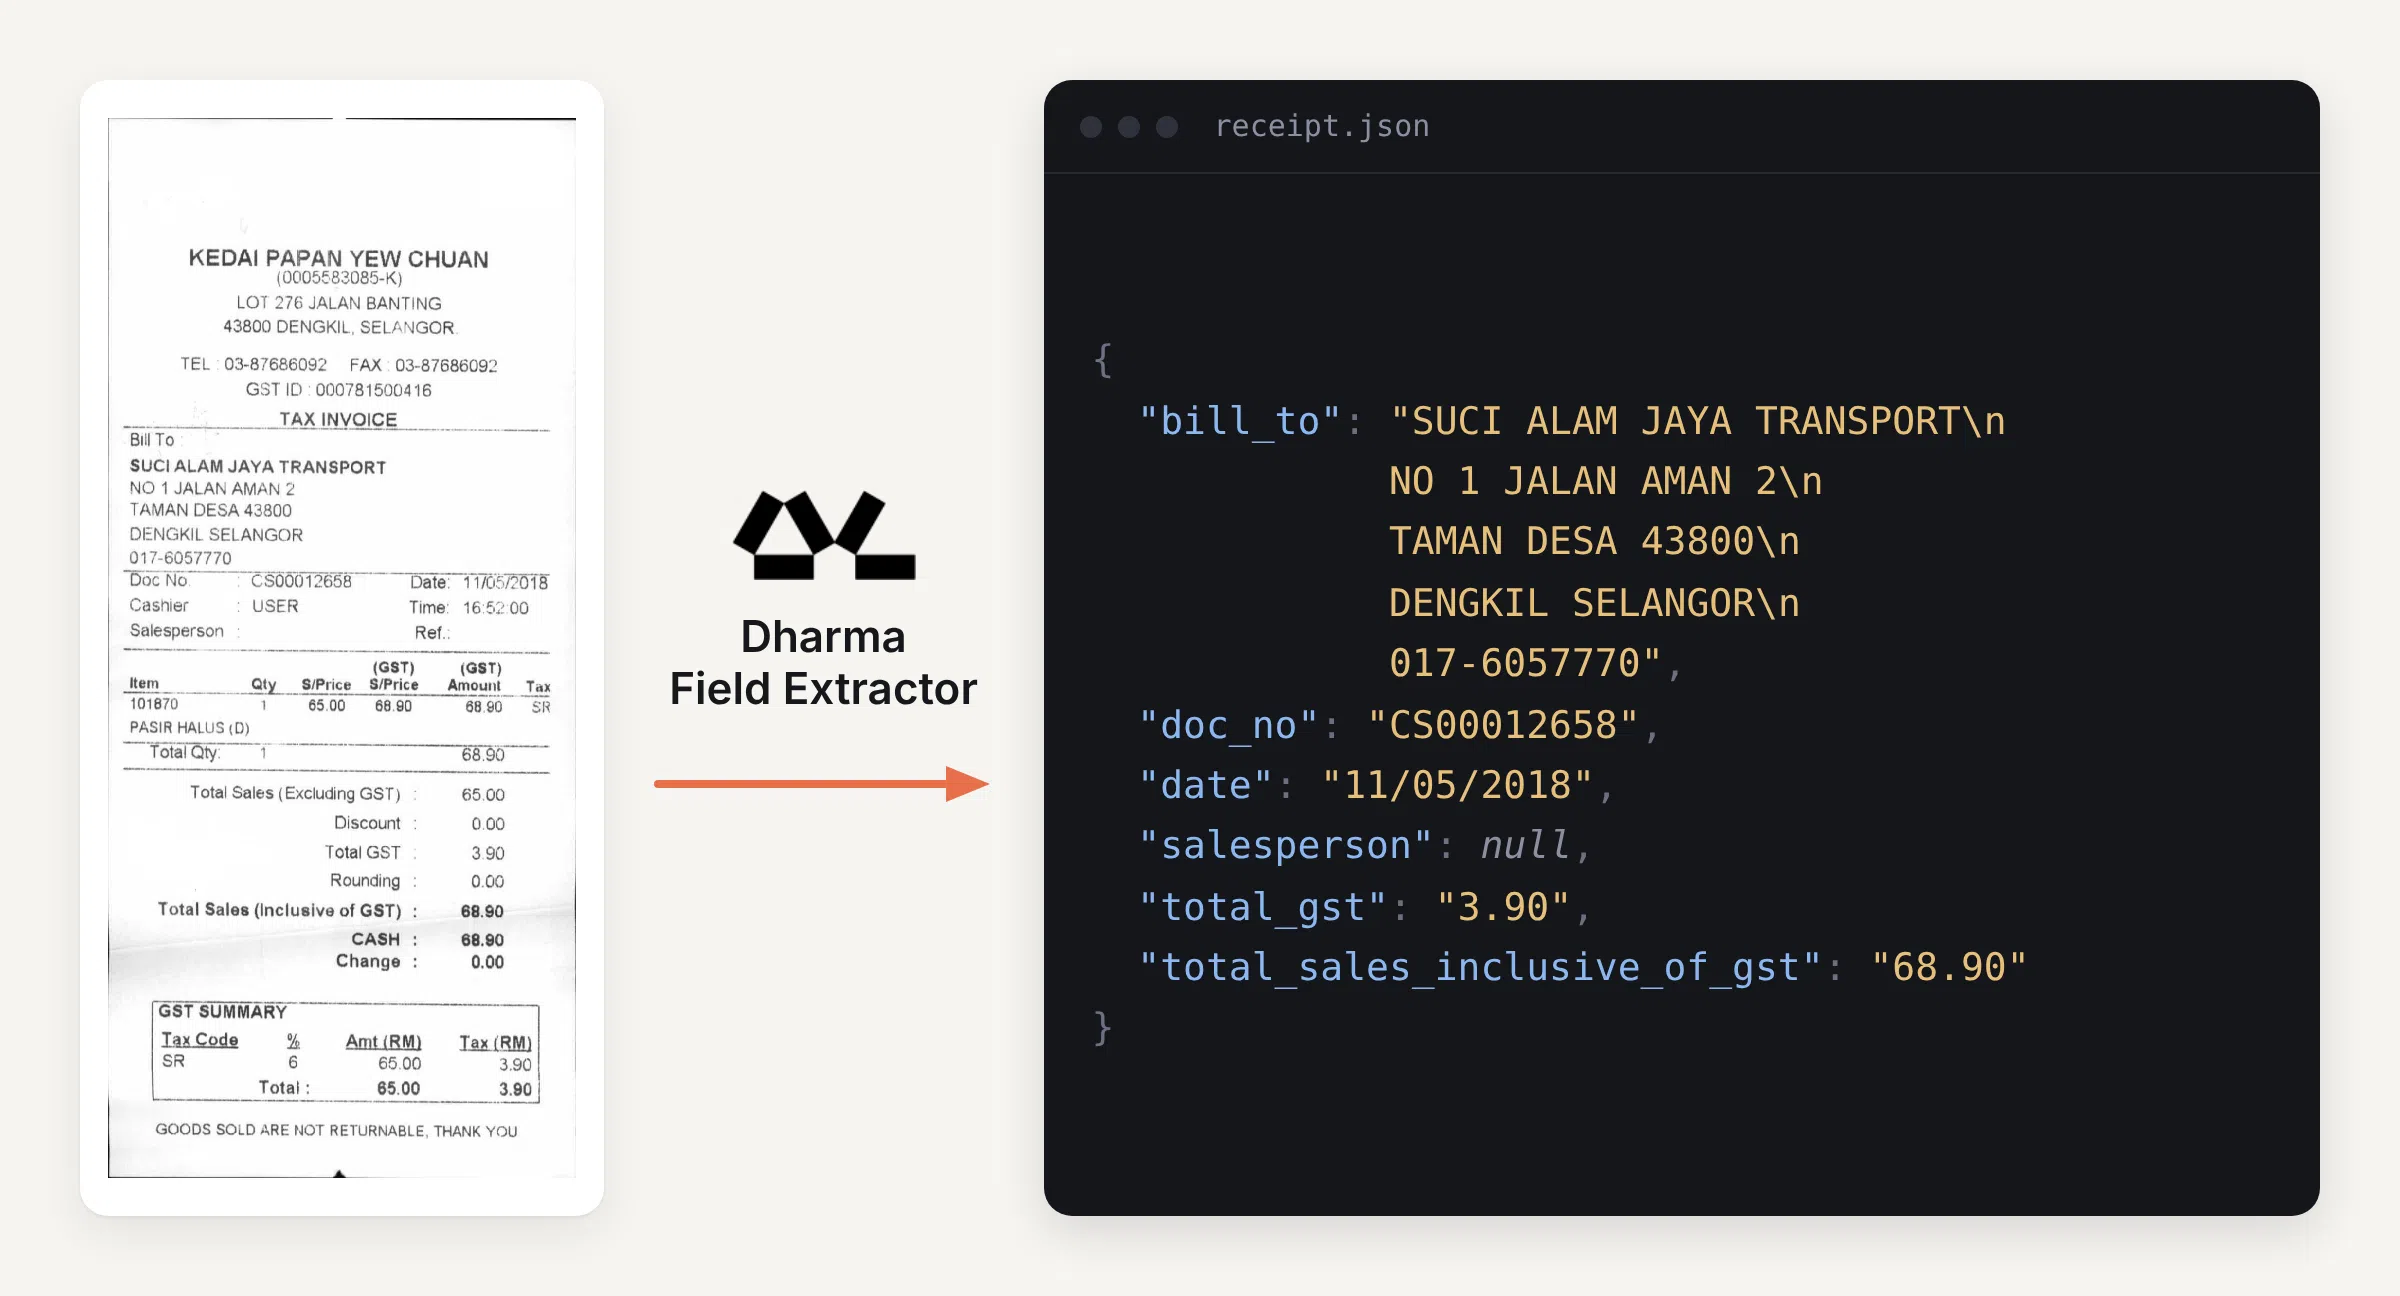
Dharma AI ha rilasciato il Field Extractor, un modello di intelligenza artificiale specializzato con 2 miliardi di parametri progettato per estrarre campi specifici da documenti di qualsiasi tipo. L'obiettivo è convertire immagini di fatture, moduli sanitari o contratti in dati strutturati in formato JSON, eliminando la necessità di scrivere codice complesso per la mappatura manuale dei dati.
Cosa cambia in pratica
A differenza dei sistemi OCR tradizionali che restituiscono solo il testo grezzo della pagina, questo modello distingue tra etichette e valori, identificando automaticamente quali dati sono rilevanti per il downstream. Per chi gestisce grandi volumi di documenti, questo approccio riduce i costi di inferenza rispetto all'uso di LLM frontiera generici, mantenendo al contempo un'alta precisione nel riempimento dei campi richiesti.
- Due modalità di estrazione: è possibile richiedere un'analisi aperta, dove il modello identifica da solo i campi strutturati, oppure fornire uno schema specifico con nomi di chiavi e tipi di dati (stringa, numero, booleano).
- Output pronto per l'integrazione: il risultato è un JSON rigoroso che segue esattamente la struttura richiesta, restituendo "null" per i campi assenti nel documento invece di inventare valori.
- Addestramento mirato: il modello si basa su DharmaOCR-LITE v1.1 e utilizza un adattatore LoRA addestrato su oltre 43.000 esempi, coprendo documenti in inglese, portoghese e altre lingue europee e asiatiche.
La specializzazione del vocabolario e dell'architettura permette al modello di operare in modo più efficiente rispetto ai modelli generali, un aspetto cruciale per le aziende che necessitano di elaborare migliaia di documenti al giorno senza incorrere in costi proibitivi per le API commerciali.
Cosa significa per chi compra in Italia
Per le imprese italiane, l'adozione di modelli specializzati come questo rappresenta un'alternativa concreta alle piattaforme cloud generiche. L'uso di un modello open-source o self-hosted permette di mantenere il controllo sui dati sensibili, un requisito fondamentale per la conformità al GDPR, soprattutto quando si trattano fatture, dati sanitari o documenti contrattuali. Non è necessario aggiornare l'hardware esistente: la natura compatta del modello (2 miliardi di parametri) consente di eseguirlo su GPU di fascia media, rendendo la soluzione accessibile anche a PMI che non dispongono di infrastrutture data center massive. Inoltre, la capacità di gestire documenti in più lingue, incluso il portoghese e l'inglese, lo rende utile per aziende con supply chain internazionali o uffici legali che gestiscono contratti multilingue.
La transizione da un'OCR pura a un'estrazione di campi strutturati riduce il tempo di sviluppo dei flussi di lavoro automatizzati, permettendo ai team IT di integrare direttamente il JSON nei database aziendali senza passaggi intermedi di parsing.
Domande frequenti
Il modello funziona con documenti in italiano?
Sì, il modello è addestrato su dati multilingue che includono lingue europee. Sebbene l'addestramento specifico menzioni inglese e portoghese, la generalizzazione su altre lingue europee è parte integrante del dataset, rendendolo adatto alla gestione di documenti in italiano.
Serve un'infrastruttura hardware dedicata?
No, essendo un modello da 2 miliardi di parametri, può essere eseguito su hardware di consumo o GPU professionali di fascia media, a differenza dei LLM frontiera che richiedono cluster di acceleratori di fascia alta.
Come gestisce i dati mancanti nel documento?
Se un campo richiesto nello schema non è presente nell'immagine del documento, il modello restituisce il valore "null" nel JSON, evitando di generare dati inventati o allucinazioni.