
Liquid AI lancia LFM3: modelli multimediali specializzati per l'edge
Liquid AI presenta LFM3, una nuova famiglia di modelli aperti da 2 miliardi di parametri. Il sistema unifica testo, visione, audio e decisioni su un'unica architettura, ottimizzata per girare su dispositivi locali con un solo GPU.
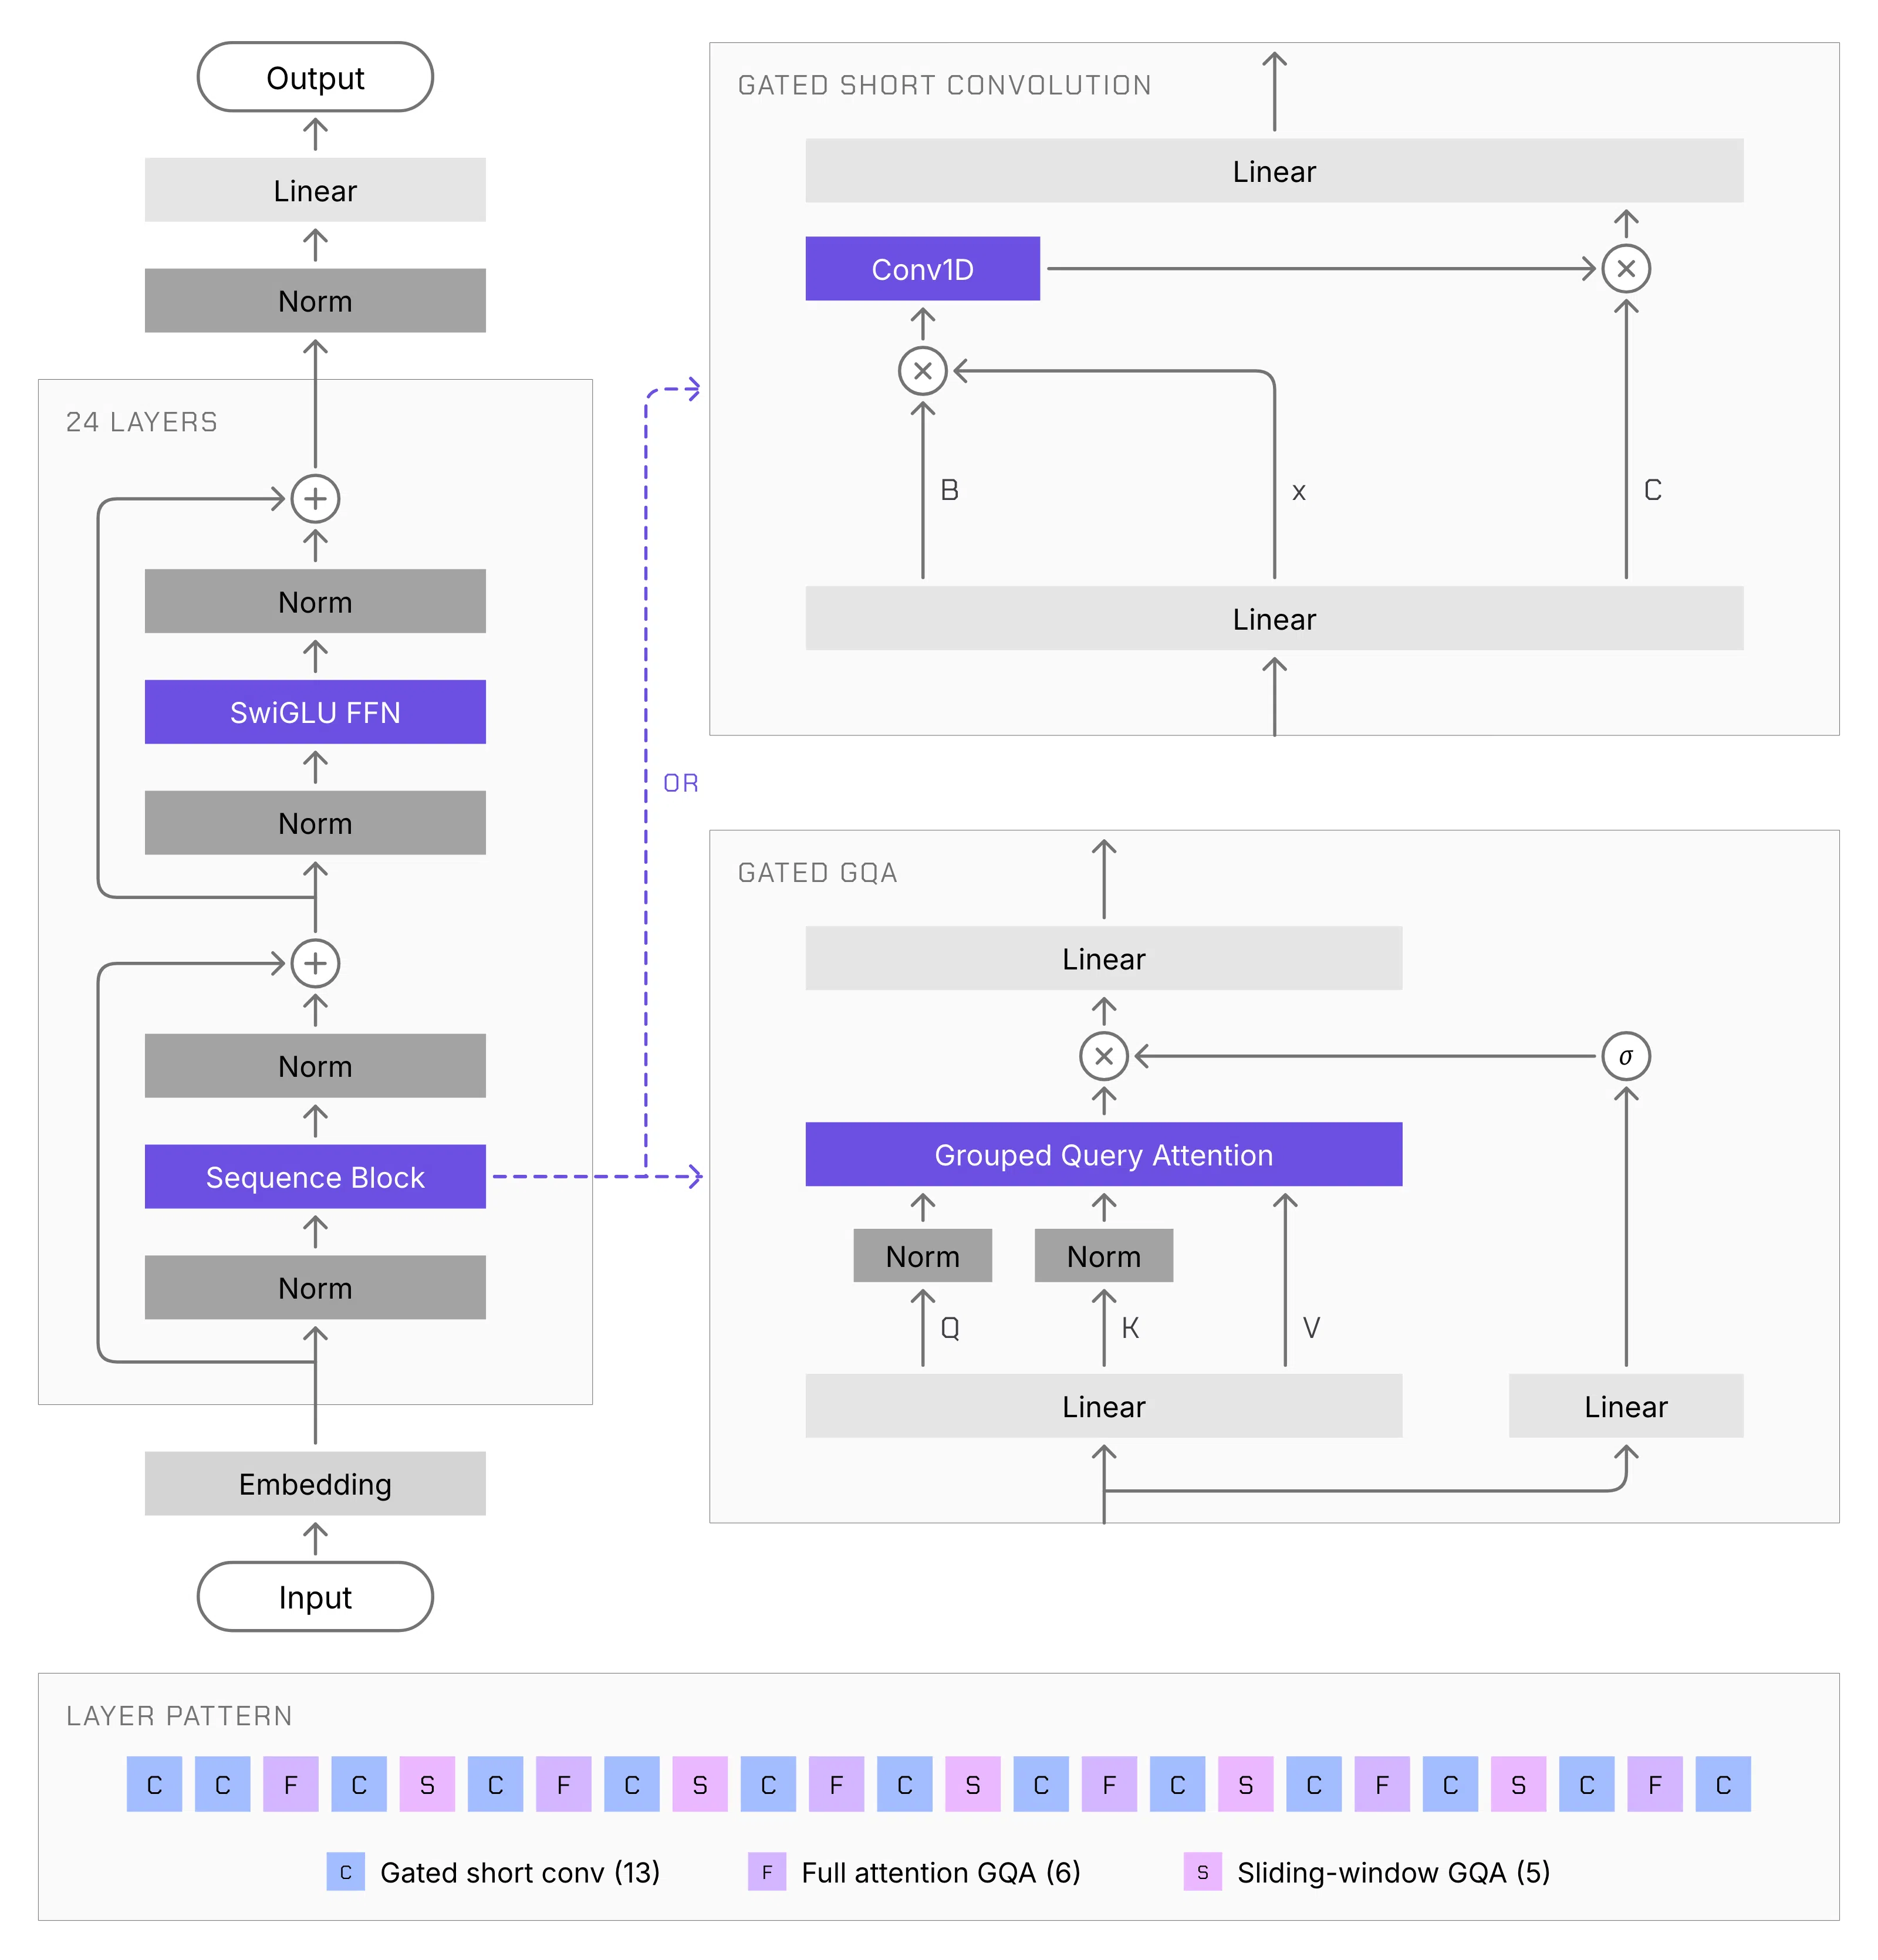
Liquid AI ha rilasciato la nuova generazione dei propri Liquid Foundation Models, denominati LFM3. Annunciata a fine ottobre 2026, questa famiglia di modelli a peso aperto introduce un approccio diverso rispetto alle grandi reti neurali centralizzate: il focus è sulla specializzazione e sull'esecuzione locale. L'obiettivo dichiarato è fornire un punto di partenza per creare intelligenze artificiali mirate, capaci di gestire testo, immagini, audio e processi decisionali senza necessariamente inviare i dati a cloud esterni.
Cosa cambia in pratica
La novità principale di LFM3 rispetto alla precedente generazione LFM2 risiede nell'efficienza e nell'unificazione delle modalità. Il modello di base, LFM3-1.7B-Base, utilizza un'architettura ibrida che combina convoluzioni e attenzione, progettata specificamente per l'uso su dispositivi edge come smartphone, Raspberry Pi e laptop. Ecco le caratteristiche tecniche distintive:
- Maggiore capacità per parametro: LFM3-1.7B supera le prestazioni di LFM2.5-2.6B utilizzando il 35% in meno di parametri, grazie a una nuova ricetta di addestramento.
- Un backbone per sei modelli: Da un'unica base derivano modelli specializzati per testo, visione, audio, input omissivi (omni) e decisioni. Per la prima volta, il modello visivo supporta anche l'input video.
- Ottimizzazione per l'edge: Il modello testuale occupa circa 1 GB a precisione 4-bit e supporta una finestra di contesto di 256K token, permettendo l'esecuzione di agenti autonomi direttamente sul dispositivo.
- Facile personalizzazione: Tutti i modelli possono essere fine-tunati su un singolo GPU, adattandosi a terminologie specifiche o dataset privati senza costi infrastrutturali elevati.
Cosa significa per chi compra in Italia
Per gli sviluppatori e le aziende italiane, LFM3 rappresenta un'alternativa concreta ai servizi di AI in cloud, particolarmente rilevante in settori dove la privacy dei dati è critica, come la sanità o la finanza. La possibilità di far girare modelli multimodali su hardware locale riduce la latenza e elimina i costi ricorrenti di inferenza cloud. Inoltre, il supporto per finestre di contesto estese permette di gestire documenti lunghi o sessioni interattive complesse senza frammentazione. Per l'utente finale, questo si traduce potenzialmente in assistenti vocali e visivi più reattivi e privati, che non richiedono la connessione a server remoti per comprendere comandi o analizzare immagini. La disponibilità dei pesi su piattaforme aperte come Hugging Face facilita l'integrazione in ecosistemi esistenti, inclusi i framework agentici locali. Per chi segue le tendenze dell'hardware compatibile con queste intelligenze, è utile consultare la nostra sezione dedicata ai componenti e periferiche informatiche per valutare le capacità di calcolo dei propri dispositivi.
Il rilascio di LFM3 consolida la tendenza verso l'AI decentralizzata, dove la potenza di calcolo si sposta dal data center al dispositivo dell'utente, offrendo maggiore controllo sui dati e flessibilità operativa.
Domande frequenti
Devo acquistare un nuovo hardware per usare LFM3?
No, non è obbligatorio. Il modello testuale da 1.7B parametri è ottimizzato per girare su hardware consumer, inclusi smartphone recenti, laptop standard e persino microcomputer come il Raspberry Pi 5, grazie alla sua bassa occupazione di memoria.
I miei dati restano sul mio dispositivo?
Sì, se esegui il modello localmente. LFM3 è progettato per l'edge computing, il che significa che l'elaborazione avviene sul tuo dispositivo. I dati non vengono inviati a server esterni a meno che tu non configuri esplicitamente un'interfaccia cloud.
È possibile adattare il modello a un uso specifico?
Sì. Liquid AI fornisce notebook per il fine-tuning che permettono di adattare i modelli a dataset specifici. Questo processo richiede solo un singolo GPU, rendendo la personalizzazione accessibile anche a team di piccole dimensioni.