Nuovi modelli d1-3B e d1-omni-600M: AI decision per l'edge
LiquidAI ha lanciato d1-3B e d1-omni-600M, modelli di decisione open source per l'edge. Scopri benchmark, velocità e come questi cambiamenti influenzano gli sviluppatori italiani.
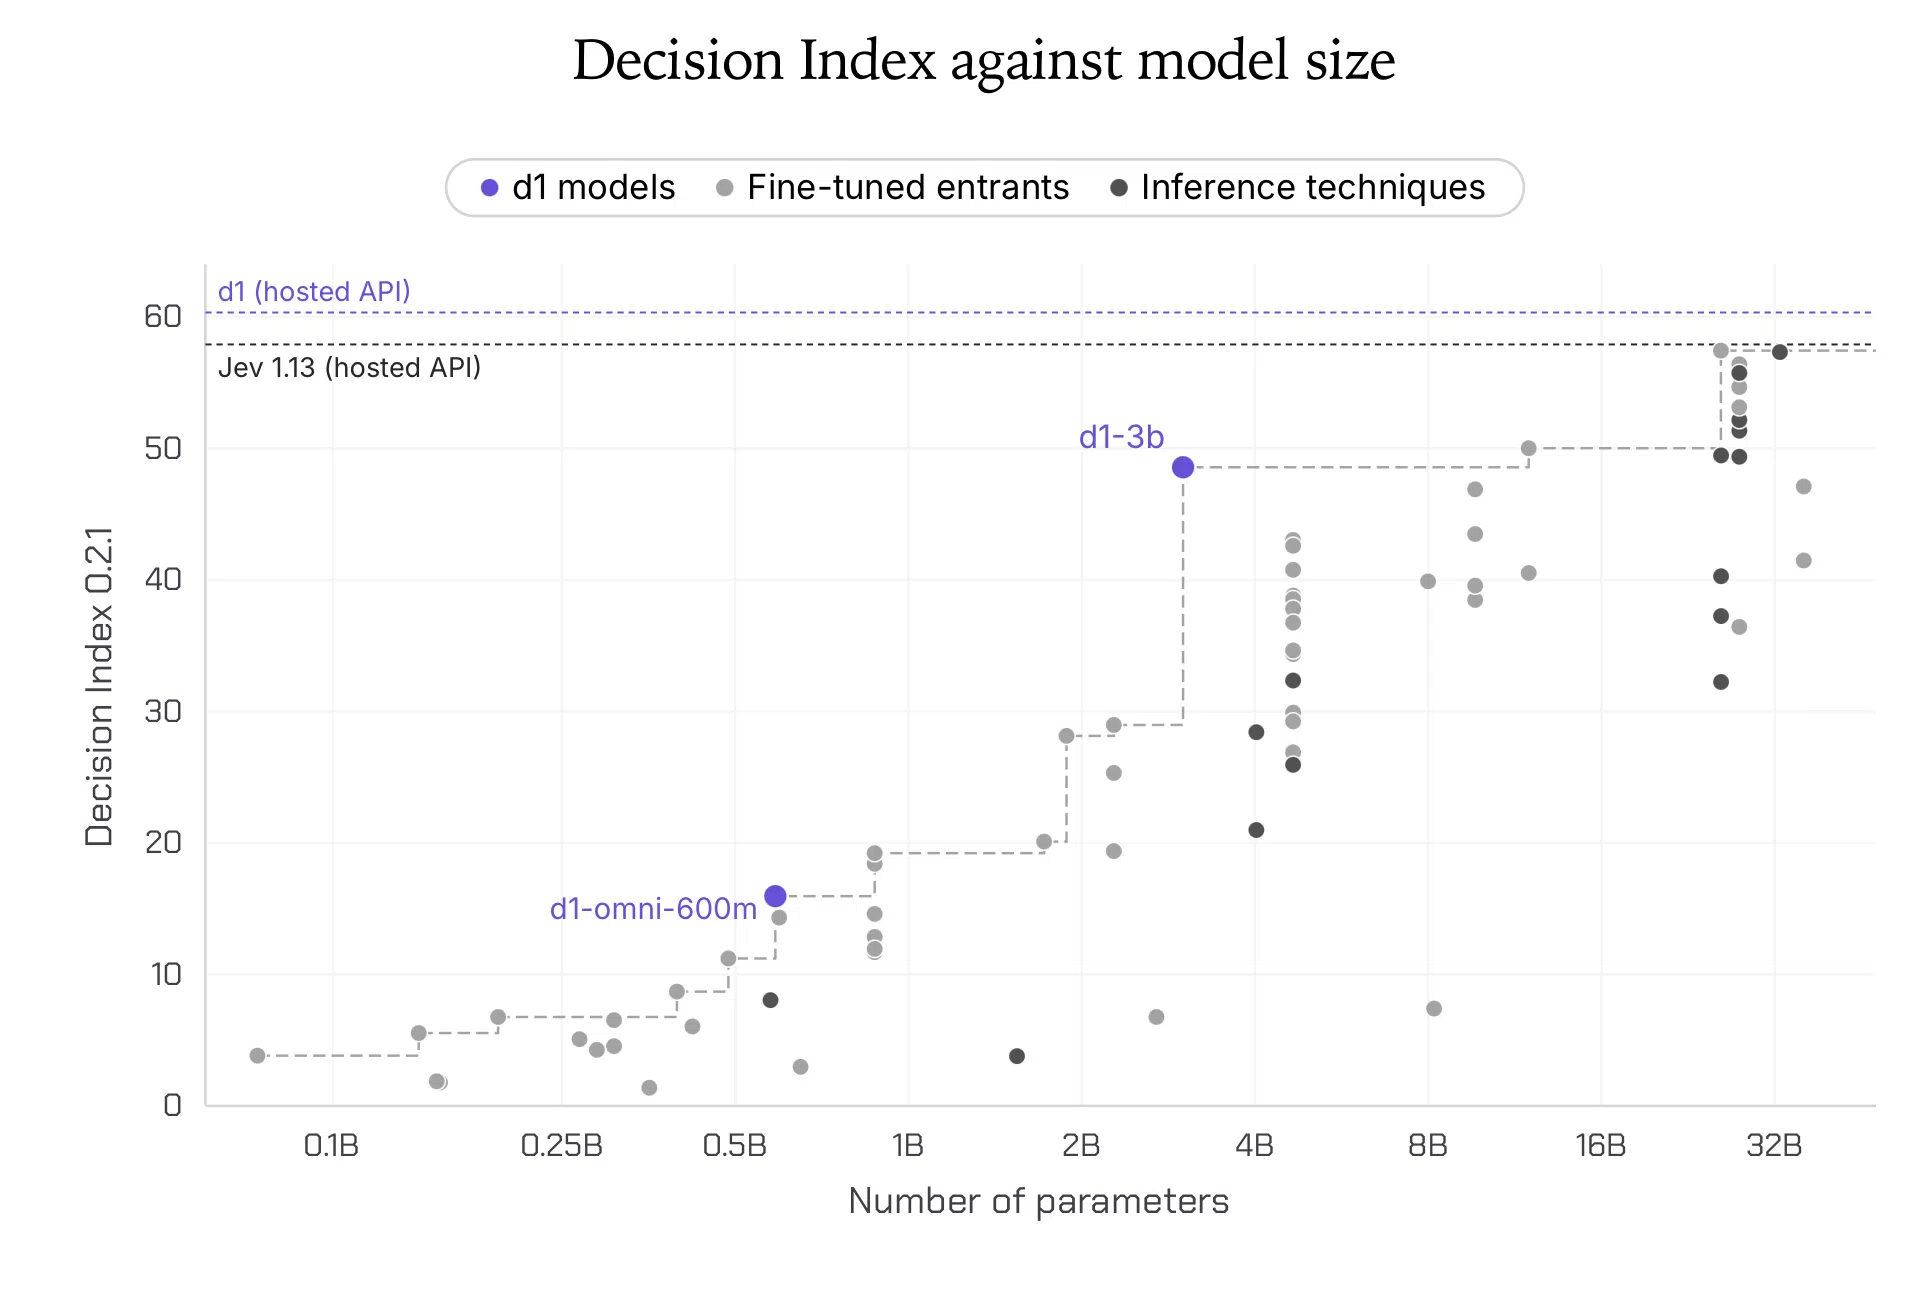
Il 7 ottobre 2026 LiquidAI ha annunciato la pubblicazione di due nuovi modelli di decisione open source, d1-3B e d1-omni-600M, progettati per l'inferenza edge. Questi sistemi promettono risposte rapide e precise su dispositivi con risorse limitate, aprendo nuove possibilità per applicazioni mobili, IoT e dispositivi embedded.
Cosa è successo
LiquidAI ha rilasciato d1-3B, basato sul backbone LFM2.5-VL-3B, e d1-omni-600M, derivato da LFM2.5-Encoder-350M. I modelli supportano input testuali, visivi e, nel caso di d1-omni-600M, anche audio. Sono stati addestrati su sette dataset pubblici, coprendo comprensione del testo, rilevamento di tossicità, classificazione dell'intento, domande mediche e comprensione cross‑linguistica.
Cosa cambia in pratica
- Multimodalità: d1-3B accetta testo e immagini, mentre d1-omni-600M gestisce testo‑immagine o testo‑audio, consentendo applicazioni più versatili.
- Velocità: d1-3B risponde in < 50 ms su dispositivi Jetson e in < 10 ms su GPU RTX 4090, rendendolo adatto a scenari in tempo reale.
- Efficienza: d1-omni-600M, con soli 600 M parametri, offre prestazioni comparabili a modelli più grandi ma con un footprint ridotto.
- Qualità delle decisioni: con un punteggio medio di 82,9 su 100, d1-3B supera i modelli Decider 4B e 2B, garantendo risposte più accurate.
- Open source: i modelli sono disponibili su Hugging Face, permettendo a sviluppatori e aziende italiane di integrarle senza costi di licenza.
Cosa significa per chi compra in Italia
Per gli sviluppatori italiani, l'arrivo di d1-3B e d1-omni-600M significa poter costruire applicazioni AI più intelligenti direttamente sul dispositivo, riducendo la dipendenza da servizi cloud e migliorando la privacy dei dati. Le aziende che operano in settori regolamentati, come la sanità o la finanza, possono sfruttare la rapidità e l'affidabilità di questi modelli per decisioni in tempo reale, mantenendo i dati all'interno delle infrastrutture nazionali.
| Modello | Media | SQuAD 2.0 | Civil Comments | MASSIVE intent | PubMedQA | BoolQ | XNLI | PAWS-X |
|---|---|---|---|---|---|---|---|---|
| d1-omni-600M | 78.4 | 74.0 | 95.8 | 86.1 | 61.3 | 77.7 | 74.7 | 79.5 |
| d1-3B | 82.9 | 83.3 | 93.3 | 86.9 | 68.3 | 86.3 | 85.6 | 76.4 |
| Decider 2B | 77.1 | 67.7 | 93.6 | 81.1 | 65.7 | 87.3 | 85.0 | 59.5 |
| Decider 4B | 81.1 | 76.0 | 92.8 | 88.3 | 63.3 | 89.0 | 88.6 | 69.8 |
Con queste performance, i modelli d1-3B e d1-omni-600M rappresentano una scelta concreta per chi necessita di decisioni rapide e affidabili su hardware limitato. L'accessibilità open source riduce l'entrata di mercato, permettendo a startup e a grandi imprese italiane di competere in ambiti come assistenza sanitaria, automazione industriale e servizi smart city.
Per approfondire l'impatto delle tecnologie AI sul mercato italiano, visita la nostra sezione Magazine dedicata all'intelligenza artificiale.
Domande frequenti
Quanti parametri ha d1-3B?
d1-3B utilizza 3,5 miliardi di parametri, offrendo un buon equilibrio tra potenza di calcolo e dimensioni.
È necessario un dispositivo NVIDIA per far girare d1-3B?
No, il modello può essere eseguito su CPU, GPU AMD o Apple M5 Pro, anche se le prestazioni migliori si ottengono su GPU NVIDIA.
Posso usare d1-omni-600M per l'analisi audio?
Sì, d1-omni-600M supporta input testuali e audio, rendendolo adatto per applicazioni di riconoscimento vocale e risposta automatica.
Come posso scaricare i modelli?
Puoi installarli tramite pip con pip install "transformers>=5.14" torch torchvision pillow e caricarli con AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True).