Intel D-Series: GPU fino a 480 GB e rack Xeon per l'AI agentica
Intel presenta le GPU D-Series con architettura Xe3P e fino a 480 GB di memoria, affiancate da rack Xeon con oltre 46.000 core. Obiettivo: ottimizzare inferenza e agenti AI nei data center.
Di che si tratta
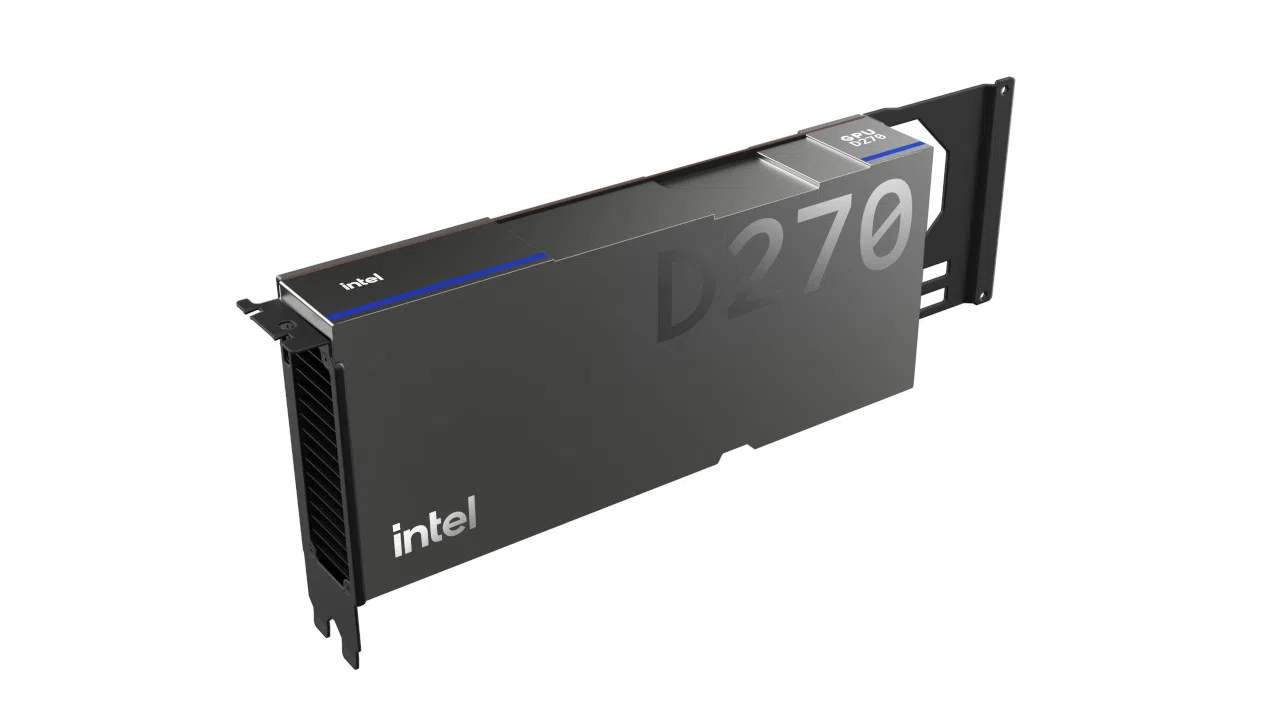
All'Open Compute Project Global Summit 2026, Intel ha delineato una strategia hardware e software pensata per l'evoluzione dell'intelligenza artificiale, in particolare per i carichi di lavoro legati all'inferenza prolungata e agli agenti AI. Il cuore dell'annuncio riguarda le nuove GPU Intel D-Series, precedentemente note come Crescent Island, e i sistemi rack ad alta densità basati su processori Xeon. L'obiettivo dichiarato è supportare modelli che non si limitano a generare testo, ma orchestrano complesse catene di operazioni, richiedendo risorse di calcolo, memoria e coordinamento CPU superiori rispetto ai tradizionali workload di addestramento o inferenza semplice.
Cosa conta davvero
- Memoria estesa per modelli grandi: Le GPU D-Series sono progettate con fino a 480 GB di memoria LPDDR5X, una capacità cruciale per eseguire modelli linguistici con centinaia di miliardi di parametri su singola scheda o configurazioni multi-GPU.
- Densità di calcolo CPU: I nuovi rack Xeon possono superare i 46.000 core con una potenza di 133,45 kW, fondamentali per orchestrare i flussi di dati e gestire le operazioni di input/output richieste dagli agenti AI.
- Efficienza e standard aperti: L'adozione dello standard Open Rack v3 (ORv3) e del formato PCIe standard facilita l'integrazione nei data center esistenti, riducendo la necessità di infrastrutture di raffreddamento specializzate.
- Prestazioni in FP8: Gli acceleratori Xe3P offrono fino a 1,3 petaflops in FP8 e una larghezza di banda di 1,5 TB/s, metriche chiave per la velocità di elaborazione dei token nei servizi di inferenza.
- Supporto software Day 0: Intel punta su una base software comune per garantire la portabilità delle applicazioni e annuncia il supporto immediato per nuovi modelli aperti, come Meta Muse Glimmer, fin dal loro rilascio.
Pro e contro
- Pro: Capacità di memoria elevata (fino a 480 GB) ideale per LLM di grandi dimensioni.
- Pro: Formato PCIe standard e raffreddamento ad aria che semplificano l'installazione in infrastrutture legacy.
- Pro: Ecosistema aperto con standard OCP che favorisce l'interoperabilità tra diversi fornitori di hardware.
- Contro: La configurazione da 480 GB è prevista per i partner OEM/ODM, mentre la scheda Intel diretta offre 160 GB.
- Contro: I rack ad alta densità richiedono una potenza elettrica significativa (oltre 133 kW), imponendo vincoli infrastrutturali severi.
Per chi ha senso (e per chi no)
Questa tecnologia è pensata per operatori cloud, grandi data center e aziende che necessitano di eseguire inferenza su modelli AI di grandi dimensioni con vincoli di latenza stringenti. Ha senso per chi cerca di ridurre i costi operativi gestendo agenti AI distribuiti su risorse miste CPU/GPU. Non è invece adatta per workstation aziendali standard o per utenti che non dispongono di infrastrutture in grado di gestire carichi di potenza così elevati e che non necessitano di capacità di memoria estrema per modelli localizzati.
Come si posiziona nella categoria
Intel si posiziona come alternativa ai fornitori di acceleratori proprietari, puntando su standard aperti e flessibilità di configurazione. La combinazione di CPU Xeon ad alta densità e GPU D-Series cerca di colmare il divario tra il calcolo general purpose e l'accelerazione specifica per l'AI, offrendo un approccio modulare rispetto a sistemi chiusi. La differenza principale rispetto alle soluzioni concorrenti risiede nell'enfasi sulla memoria on-board per l'inferenza e nella compatibilità con gli standard OCP per la gestione dei rack.
Domande frequenti
Qual è la differenza tra la GPU Intel e quelle dei partner?
La scheda commercializzata direttamente da Intel integra 160 GB di memoria LPDDR5X, mentre il progetto tecnico consente ai partner di realizzare configurazioni flessibili fino a un massimo di 480 GB.
Gli agenti AI richiedono davvero così tante CPU?
Sì, perché oltre alla generazione delle risposte, gli agenti devono coordinare il recupero di informazioni, l'uso di strumenti e l'esecuzione di attività multiple, processi che richiedono risorse CPU dedicate all'orchestrazione e al trasferimento dati.
È necessario un raffreddamento a liquido per queste GPU?
No, le GPU D-Series adottano un sistema di raffreddamento ad aria standard, progettato per funzionare nei data center esistenti senza richiedere infrastrutture di raffreddamento specializzate.
Quali modelli AI sono supportati al lancio?
Intel ha dichiarato il supporto Day 0 per modelli aperti recenti come Meta Muse Glimmer, con l'obiettivo di facilitare le prime valutazioni e l'implementazione in produzione tramite il suo toolkit software.