
LFM2.5‑VL‑DSpark: la nuova accelerazione per modelli vision‑language
Liquid AI ha introdotto LFM2.5‑VL‑DSpark, un draft speculativo che riduce i tempi di inference fino a 3,13× su dispositivi e 2,66× su GPU H100, con solo un 8,9% in più di parametri. Scopri come cambia l’esperienza AI in Italia.
Cosa è successo
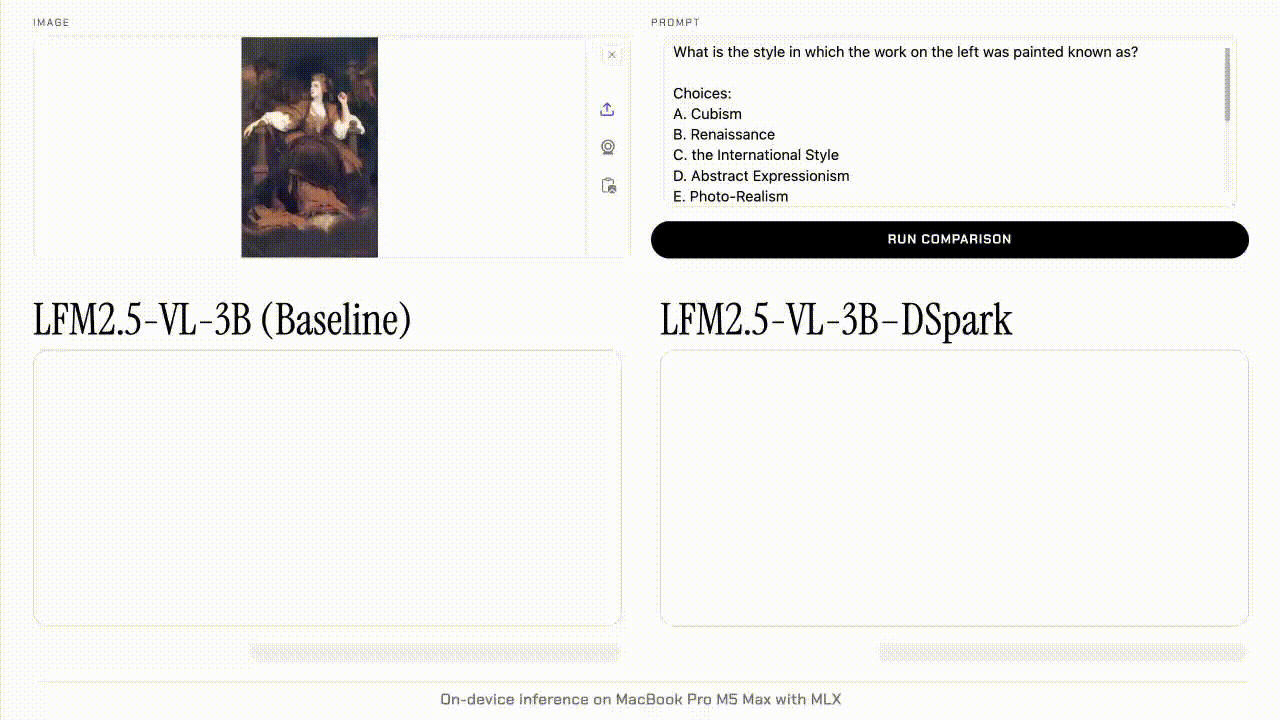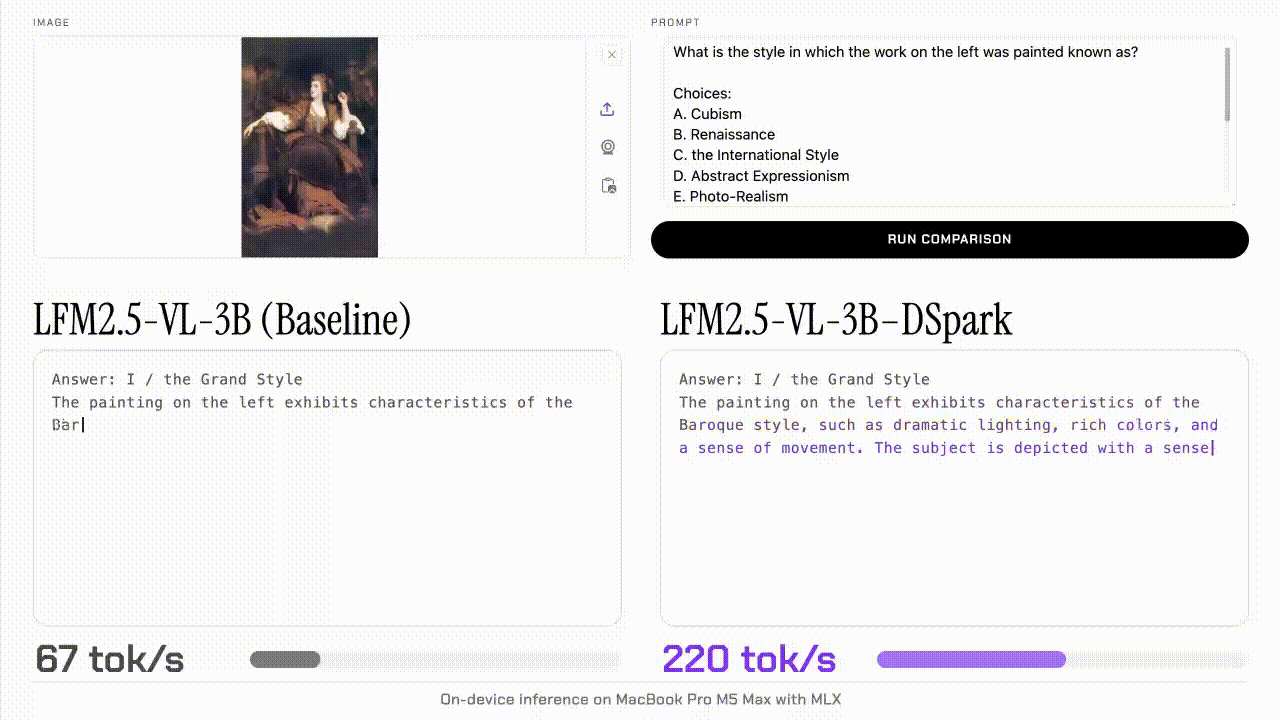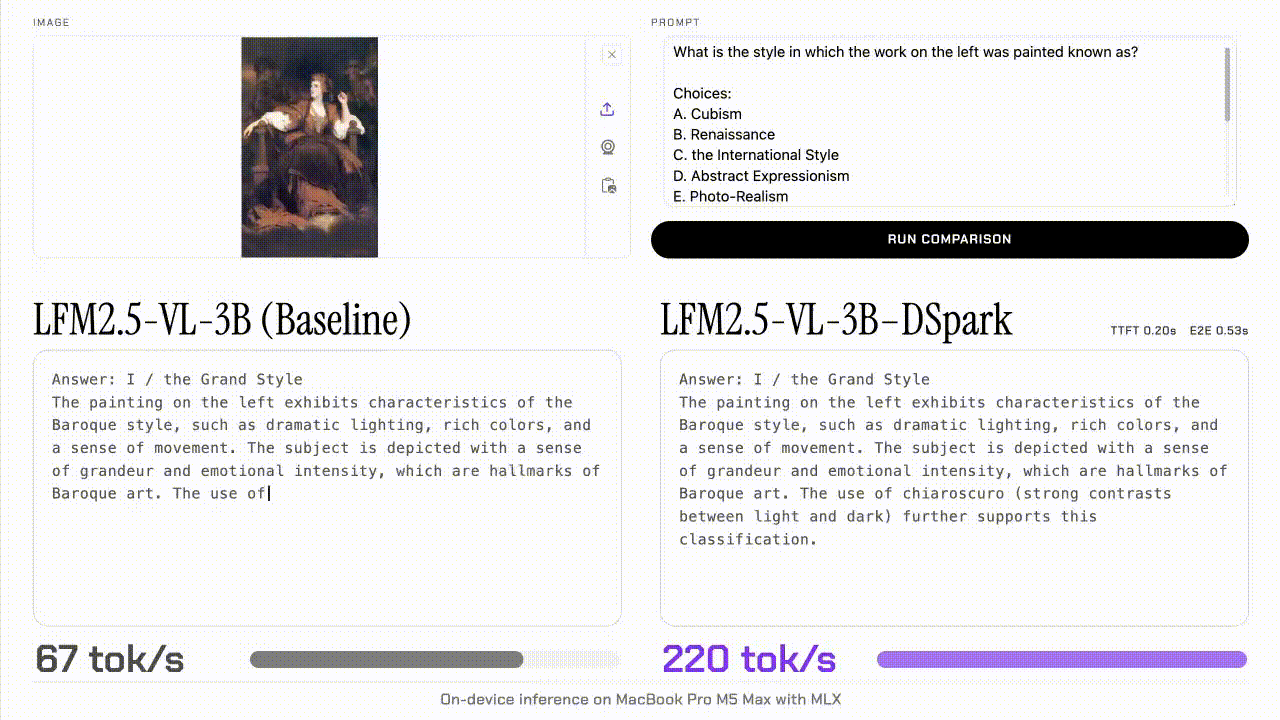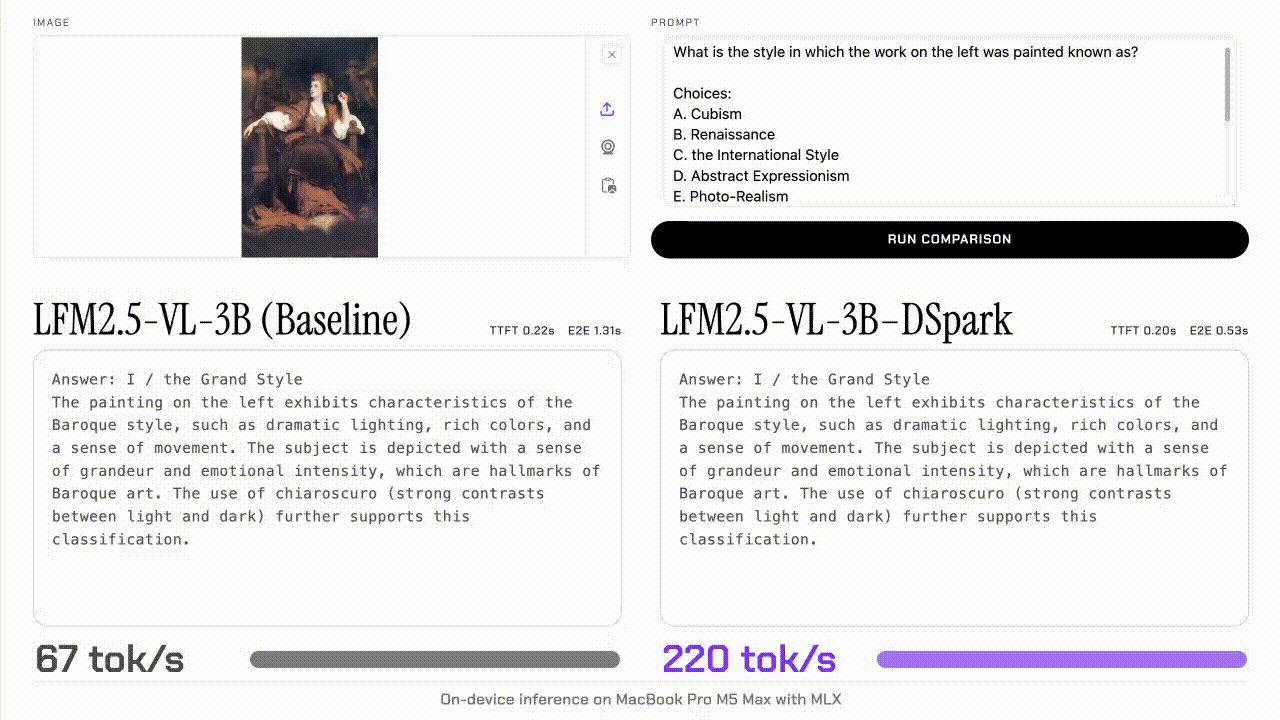
Il 24 settembre 2026 Liquid AI ha pubblicato LFM2.5‑VL‑DSpark, una versione sperimentale del modello vision‑language LFM2.5‑VL‑3B. La novità è un “draft” speculativo che aggiunge un percorso di decoding alternativo, consentendo di ridurre i tempi di inference senza alterare la qualità delle risposte.
Cosa cambia in pratica
- Velocità di decoding: fino a 3,13× più veloce su dispositivi Apple Silicon (M5 Max, M3 Ultra) e 2,66× su GPU H100.
- Velocità end‑to‑end: miglioramenti compresi tra 1,56× e 2,62× su CPU e 1,64× e 2,27× su GPU.
- Costi di memoria: il draft aggiunge 280 M parametri, pari all’8,9 % in più rispetto al modello base.
- Supporto day‑one: compatibilità immediata con llama.cpp, MLX‑VLM e SGLang, facilitando l’implementazione su piattaforme diverse.
- Open‑weight: i modelli sono disponibili in formati Safetensors e GGUF, consentendo download, fine‑tuning e deployment senza restrizioni.
| Configurazione | Velocità di decoding | Velocità end‑to‑end |
|---|---|---|
| CPU (M5 Max, M3 Ultra) | 2,30×–3,13× | 1,56×–2,62× |
| GPU (H100) | 20,4×–2,66× | 1,64×–2,27× |
Cosa significa per chi compra in Italia
Per gli utenti italiani, LFM2.5‑VL‑DSpark rappresenta un passo avanti nella fruizione di AI sul device. Grazie al minor consumo di memoria e alla maggiore velocità, è possibile eseguire modelli complessi di vision‑language su smartphone, tablet o laptop senza ricorrere a server remoti. Ciò riduce la dipendenza dalla connettività 4G/5G e migliora la privacy, poiché i dati non devono essere inviati a server esterni.
Il fatto che il modello sia open‑weight facilita la personalizzazione da parte di sviluppatori locali, permettendo di adattarlo a esigenze specifiche del mercato italiano, come la traduzione automatica di testi multilingue o l’analisi di immagini per la sicurezza domestica.
Infine, la compatibilità con piattaforme di inference già diffuse (llama.cpp, MLX‑VLM, SGLang) significa che le aziende di tecnologia e i produttori di componenti possono integrare rapidamente la nuova tecnologia nei propri prodotti, offrendo ai consumatori finali un’esperienza AI più veloce e più efficiente.
Domande frequenti
Quali dispositivi supportano LFM2.5‑VL‑DSpark?
Il modello è stato testato su Apple Silicon (M5 Max, M3 Ultra) e su GPU NVIDIA H100. In teoria è compatibile con qualsiasi hardware che supporti i framework indicati (llama.cpp, MLX‑VLM, SGLang).
L’uso di questo modello impatta la privacy dei miei dati?
Poiché il modello può essere eseguito localmente, i dati non devono essere inviati a server esterni, riducendo i rischi di esposizione. Tuttavia, è sempre consigliabile verificare le impostazioni di sicurezza del dispositivo.
È necessario un nuovo smartphone per sfruttare i benefici?
No, basta un dispositivo con capacità di inference compatibile. Anche i modelli più recenti di laptop con GPU integrata possono trarre vantaggio dalle ottimizzazioni.
Ci sono alternative più private?
Alcuni modelli open‑source, come quelli disponibili su Hugging Face, offrono configurazioni simili. Tuttavia, LFM2.5‑VL‑DSpark è unico per la combinazione di velocità e compatibilità day‑one.
Dove posso approfondire l’argomento?
Visita la sezione magazine per articoli e approfondimenti sull’intelligenza artificiale.