
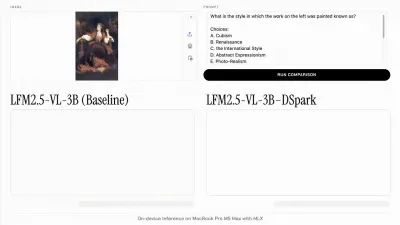
LFM2.5‑VL‑DSpark: la nuova accelerazione per modelli vision‑language
Liquid AI ha introdotto LFM2.5‑VL‑DSpark, un draft speculativo che riduce i tempi di inference fino a 3,13× su dispositivi e 2,66× su GPU H100, con solo un 8,9% in più di parametri. Scopri come cambia l’esperienza AI in Italia.