NVIDIA e IIT Madras lanciano dataset AI da 2,8 trilioni di token per le lingue indiane
Nuovo corpus open source per l'addestramento di modelli linguistici in 22 lingue indiane. Analisi su dati, pipeline GPU e impatto pratico per sviluppatori e privacy.
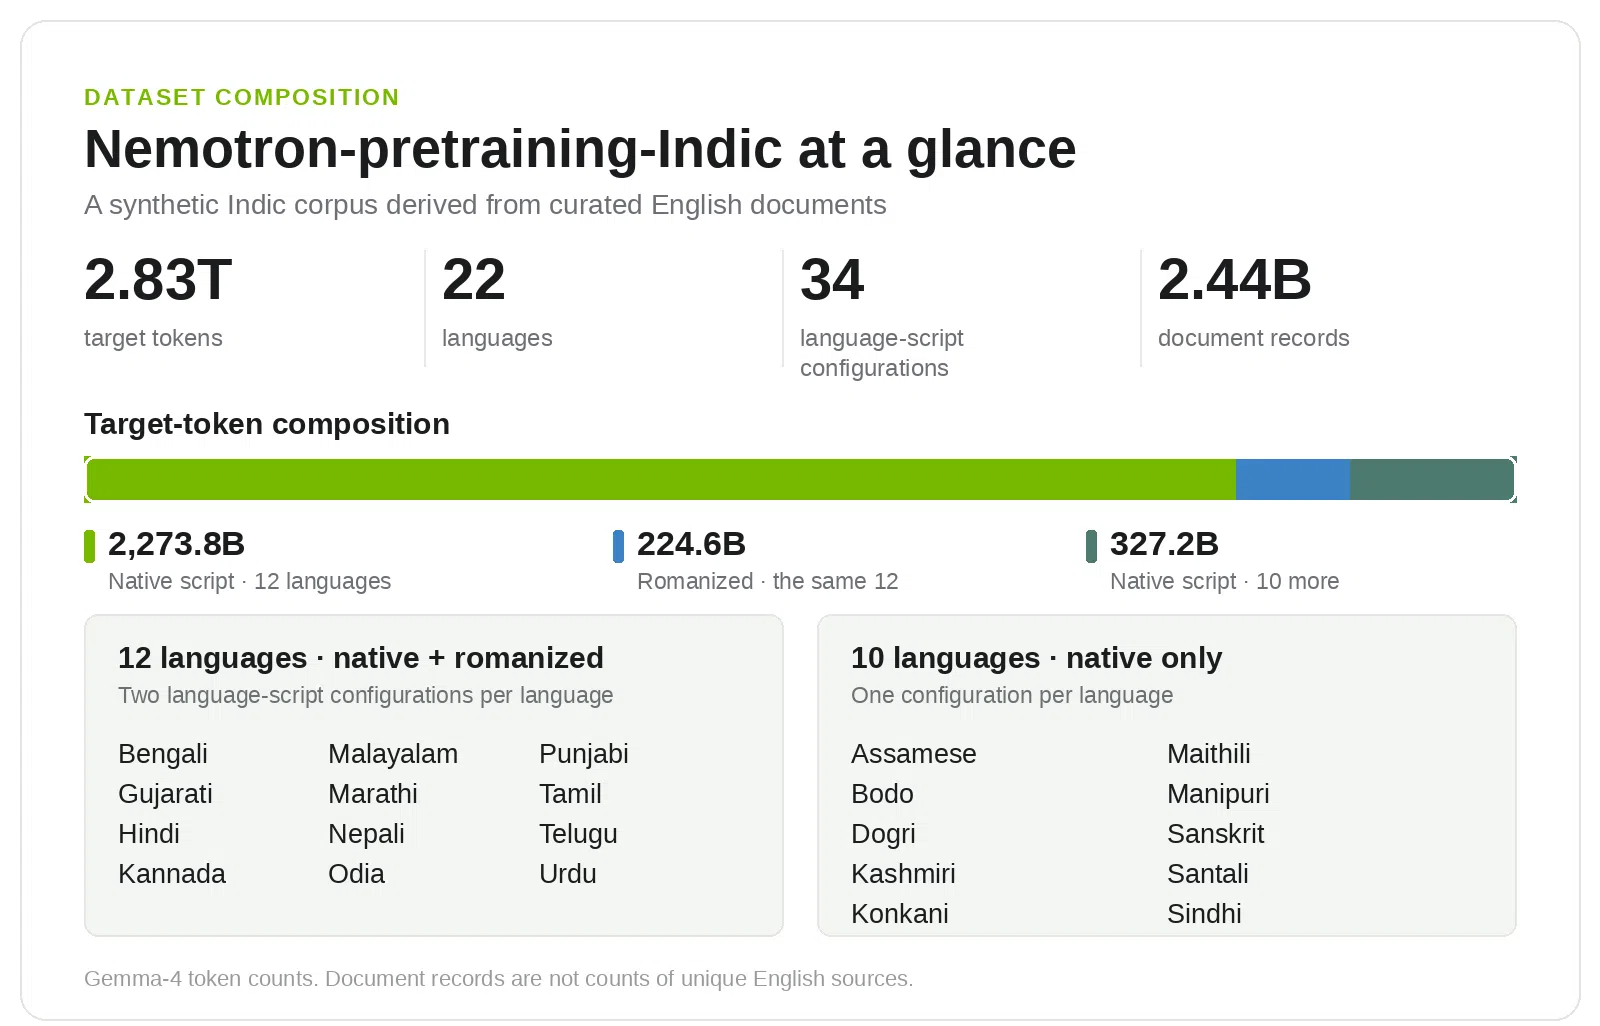
NVIDIA e il laboratorio AI4Bharat dell'IIT Madras hanno annunciato la disponibilità di "Nemotron-pretraining-Indic-v1", un corpus di pre-addestramento composto da 2,8 trilioni di token distribuiti su 22 lingue indiane. Il rilascio, avvenuto a ottobre 2026, include non solo i dati ma anche la pipeline GPU-accelerata utilizzata per la loro generazione, rendendo il processo trasparente e replicabile per la comunità di sviluppatori.
Cosa cambia in pratica
Questa iniziativa affronta la carenza di dati di alta qualità per le lingue indiane, un collo di bottiglia storicamente superiore rispetto all'inglese. Il corpus non è un semplice insieme di testi grezzi, ma una risorsa strutturata che combina materiale curato (matematica, codice, domande e risposte) tradotto e adattato. Ecco i punti chiave del rilascio:
- Copertura linguistica: Include dati in script nativo per tutte le 22 lingue previste dalla Costituzione indiana e versioni romanizzate per 12 di esse, per un totale di 34 configurazioni lingua-script.
- Pipeline aperta: I prompt, i flussi di lavoro LLM e i controlli di qualità sono resi pubblici, permettendo ai team di generare dati aggiuntivi partendo da fonti proprie.
- Tracciabilità: Ogni record sintetico è collegato a un documento sorgente curato e verificato, riducendo il rischio di allucinazioni o informazioni errate nel modello finale.
Cosa significa per chi compra in Italia
Per l'utente finale italiano, l'impatto diretto è limitato, poiché i modelli addestrati su questi dati mirano specificamente al mercato indiano. Tuttavia, per sviluppatori e aziende che operano a livello globale, questo dataset rappresenta una risorsa significativa per costruire assistenti virtuali e sistemi di elaborazione del linguaggio naturale (NLP) più accurati in contesti multilingue. L'apertura della pipeline suggerisce che il settore dell'AI sta spostando l'attenzione dalla semplice disponibilità di chip alla qualità e alla diversità dei dati di addestramento. Per chi sviluppa applicazioni locali, il principio resta valido: la privacy dei dati è fondamentale. Utilizzare dataset open source riduce la dipendenza da provider cloud terzi per l'addestramento, ma è sempre necessario verificare dove vengono elaborati i dati personali durante le fasi di inferenza. In Italia, la compliance con il GDPR richiede che i dati degli utenti non vengano utilizzati per addestrare modelli senza consenso esplicito, indipendentemente dal fatto che il corpus di base sia pubblico.
La collaborazione tra NVIDIA e l'IIT Madras segnala una tendenza verso ecosistemi AI più decentralizzati e specializzati, dove la qualità dei dati linguistici diventa un fattore competitivo quanto la potenza di calcolo hardware.
Domande frequenti
I dati personali degli utenti italiani sono a rischio?
No. Questo dataset è composto da testi curati e sintetizzati per l'addestramento di modelli generici. Non contiene dati personali di utenti specifici e, anche se utilizzato per addestrare modelli commerciali, non implica l'accesso ai dati privati degli utenti italiani a meno che questi non interagiscano esplicitamente con servizi che li richiedono.
Serve un hardware specifico per usare questi dati?
Sì. La pipeline di generazione e l'addestramento di modelli su 2,8 trilioni di token richiedono infrastrutture GPU di fascia enterprise. Gli sviluppatori possono tuttavia accedere ai dati per task di fine-tuning su hardware meno potente, a seconda della scala del modello target.
È disponibile un'alternativa più privata per l'addestramento?
I dataset open source come questo permettono l'addestramento locale, offrendo un controllo maggiore sulla privacy rispetto ai servizi cloud chiusi. Tuttavia, l'uso di strumenti come NeMo Data Designer o Gemma implica comunque l'uso di software di terze parti, la cui licenza e policy di privacy devono essere verificate prima di un deploy in ambienti sensibili.