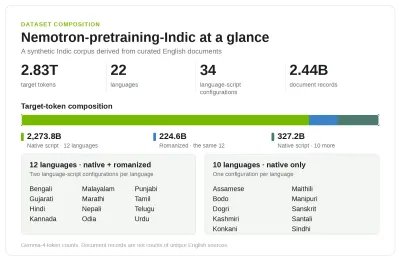
NVIDIA e IIT Madras lanciano dataset AI da 2,8 trilioni di token per le lingue indiane
Nuovo corpus open source per l'addestramento di modelli linguistici in 22 lingue indiane. Analisi su dati, pipeline GPU e impatto pratico per sviluppatori e privacy.